Cik daudz RAM vajag, lai klēpjdatorā lokāli darbinātu MI?
Neliels MI modelis, kas darbojas tavā klēpjdatorā, jau tagad var apstrādāt tekstu un attēlus un atbildēt uz taviem jautājumiem, turklāt tam nav vajadzīgs mākoņpakalpojuma konts. Modelis qwen3.5:4b-q4_K_M (Qwen), kura lejupielādes apjoms ir 3,4 GB, to visu var paveikt jau šovakar parastā klēpjdatorā ar 16 GB atmiņas. Tas ir LLM, jeb liels valodas modelis. Lejupielādē to ar Ollama, uzdod vienu jautājumu ar 4K kontekstu, un tu jau lokāli darbini īstu MI modeli datorā, kas tev jau pieder. Tas lasa tekstu un attēlus, un tā ir inferēšana, nevis apmācība: te modelim neviens neko jaunu nemāca, tas vienkārši atbild.
Neskaidra "AI PC" uzlīme uz klēpjdatora kastes nav specifikācija. Svarīga ir RAM, GPU izmantojamā atmiņa, krātuve un reāls programmatūras atbalsts. 16 GB atmiņas ir īsts sākuma punkts maziem MI modeļiem, nevis minimums, ko uzreiz norakstīt, un arī ne solījums, ka darbosies viss, ko sola specifikāciju lapa. Lielāka atmiņa dod vairāk konteksta un vairāk vietas daudzuzdevumu darbam. Ar 16 GB var sākt.
Kas īsti izmanto klēpjdatora RAM, kad darbini MI
Modeļa lejupielādes izmērs un RAM patēriņš darbības laikā ir divi atšķirīgi skaitļi, un to sajaukšana ir visizplatītākā kļūda, izvēloties klēpjdatoru MI vajadzībām. Tie 3,4 GB, ko lejupielādē qwen3.5:4b-q4_K_M modelim, ir fails diskā. Lai to ielādētu, vajag reālu atmiņu. Atmiņu patērē arī konteksta logs, proti, saruna, ko modelis patur prātā, kamēr atbild, un ko sauc par KV kešatmiņu. Atmiņu izmanto arī pats dzinis, kā arī viss pārējais, ko jau lieto tava operētājsistēma un citas lietotnes.
Ollama pēc noklusējuma ielādē 4 096 tokenu kontekstu, un tu to vari palielināt. Ja vienlaikus palaid vairākus pieprasījumus, konteksta atmiņas vajadzība pieaug aptuveni proporcionāli paralēlo pieprasījumu skaitam. Modeļa specifikācijā var būt norādīts 128K vai 256K tokenu konteksta logs, taču uztver to kā modeļa maksimālo robežu, nevis solījumu, ka tavs 16 GB klēpjdators to visu varēs izmantot uzreiz.
RAM, VRAM un vienotā atmiņa nav viens un tas pats
Apple Silicon čipi izmanto vienoto atmiņu: CPU un GPU lieto vienu un to pašu 16, 24 vai 32 GB kopni, tāpēc nav atsevišķas grafiskās atmiņas, kas varētu beigties pati par sevi. Tipisks Windows vai Linux klēpjdators ar atsevišķu NVIDIA GPU darbojas citādi. Sistēmas RAM un pašam GPU paredzētā VRAM ir divi atsevišķi atmiņas apjomi, un 16 GB sistēmas RAM kopā ar 8 GB GPU nav viens brīvi izmantojams 24 GB kopums.
Ja modelis pilnībā neietilpst GPU atmiņā, daļa darba tiek veikta uz CPU. Tā ir daļēja pārlikšana uz CPU, un tās dēļ modelis, kuru tehniski var palaist, praksē var darboties manāmi lēnāk. Palaid , un tas precīzi parāda, kāds CPU/GPU sadalījums ir katram pašlaik ielādētajam modelim.
Ietilpība ir tikai puse no stāsta. Tikpat svarīgi ir tas, cik ātri šī atmiņa pārvieto datus: Apple norāda 153 GB/s atmiņas joslas platumu MacBook Air M5 modelim, un tieši joslas platums, ne tikai apjoms, ir viens no iemesliem, kāpēc vienotā atmiņa šķiet atsaucīga, nevis tikai tehniski pietiekama.
Kvantēšana: kā 9B MI modelis sarūk, lai ietilptu tavā RAM
Kvantēšana ir iemesls, kāpēc šī lejupielāde aizņem tikai 3,4 GB: modeļa svari tiek glabāti ar zemāku skaitlisko precizitāti, un Qwen3.5 9B modelis to labi parāda. Tas pats 9B modelis aizņem 6,6 GB kā Q4_K_M, 11 GB kā Q8_0 un 19 GB pilnā BF16 precizitātē. Tas pats modelis, tas pats parametru skaits, bet trīs ļoti atšķirīgi lejupielādes izmēri, un atkal jāatceras: tas ir lejupielādes izmērs, nevis RAM daudzums, kas vajadzīgs darbības laikā.
Zemāka precizitāte parasti nozīmē arī zināmu kvalitātes kritumu, bet tas, cik liels tas būs, ir atkarīgs no uzdevuma, nevis no kāda fiksēta procenta. Vēl viena praktiska nianse, ko vērts zināt, pirms izvēlies Qwen kā pirmo modeli: daļa lietotāju ziņo, ka tā "domāšanas" solis rada pamanāmu pauzi, pirms parādās atbilde, salīdzinot ar modeļiem, kas atbild tiešāk. Tāpēc ir vērts izmēģināt abus stilus savos uzdevumos, nevis uzreiz pieņemt, ka viens variants vienkārši ir labāks.
Tev jau ir MacBook ar 16 GB? Izmēģini šo, pirms kaut ko pērc
Ja tev jau ir MacBook ar 16 GB, sāc ar 2–4B modeli Q4 precizitātē un 4K kontekstu, pirms vispār domā par citu pirkumu. Var ielādēties arī 9B Q4 modelis vai kas līdzīgs Gemma 4 12B QAT. Tas, vai tas darbosies, ir atkarīgs no tā, cik daudz citu lietotņu ir atvērtas, cik lielu kontekstu izmanto un cik noslogota ierīce jau ir, tāpēc uztver to kā iespēju, ko vērts pārbaudīt, nevis garantiju.
Meklē jaunu datoru tieši šim nolūkam? MacBook Air 13 collu ar M5 čipu standarta komplektācijā ir 16 GB vienotās atmiņas, un to var konfigurēt līdz 32 GB. Un vēl pirms lielāks ekrāns sāk vilināt kā uzlabojums: 15 collu M5 Air sākas ar tieši tām pašām 16, 24 un 32 GB atmiņas opcijām un to pašu 153 GB/s joslas platumu kā 13 collu modelis. Ekrāna izmēru izvēlies ērtībai, nevis tāpēc, ka tas dotu vairāk vietas MI darbam. To tas nedod.

Tev jau ir Windows vai Linux klēpjdators ar 16 GB? Sāc te
Windows vai Linux klēpjdators ar 16 GB bez atsevišķa GPU joprojām var darbināt mazu modeli. Ollama darbojas tieši uz Windows, tāpēc lejupielādē 2–4B Q4 modeli un vispirms pamēģini to palaist uz CPU vai integrētās grafikas, pirms tērē naudu. Sagaidi lielākas atšķirības darbībā nekā uz Apple Silicon: nav viena fiksēta tokenu sekundē rādītāja, kas attiektos uz visām ierīcēm, jo neviens nav izmērījis katru konfigurāciju.
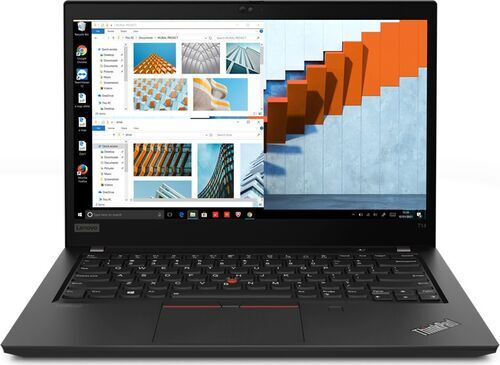
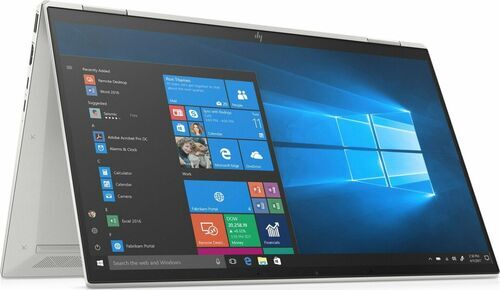
Gan Lenovo ThinkPad T14 G2, gan HP EliteBook x360 1040 G7 ir ar 16 GB RAM un integrēto grafiku, tātad tieši šajā līmenī. Viena lieta, ko vērts pārbaudīt vispirms, īpaši vecākam atjaunotam datoram, kā šie abi modeļi: LM Studio uz Windows x64 prasa AVX2 atbalstu, un ne visiem vecākiem procesoriem tas ir. Pārliecinies, ka tavs konkrētais procesors to atbalsta, pirms pieņem, ka jebkurš šīs klases klēpjdators darbinās izvēlēto rīku.
Klēpjdatoru GPU nosaukumu slazds: kāpēc "RTX 5070 Ti" nav viens skaitlis
NVIDIA klēpjdatoru GPU nosaukumi sakrīt ar galddatoru videokaršu nosaukumiem, taču šis nosaukums pasaka mazāk, nekā varētu šķist. RTX 5060 Laptop GPU ir 8 GB GDDR7 atmiņas un publicēts jaudas diapazons no 45 līdz 100 vatiem. RTX 5070 Ti Laptop GPU ir 12 GB GDDR7 un no 60 līdz 115 vatiem. Rezultāts internetā par galddatora RTX 5070 Ti nav tas pats, kas rezultāts klēpjdatoram ar RTX 5070 Ti Laptop GPU, lai gan nosaukums liek domāt citādi.
Tajā pašā nosaukumā slēpjas vēl viens slazds. Diviem klēpjdatoriem var būt viens un tas pats "RTX 5070 Ti Laptop GPU", bet ilgstošas slodzes apstākļos tie var darboties atšķirīgi: plāns un viegls korpuss, kā arī biezāks un smagāks korpuss siltumu novada atšķirīgi, un viens un tas pats GPU nosaukums negarantē vienādu ātrumu reālā lietošanā pēc tam, kad ventilatori jau kādu laiku darbojas. Vienmēr pārbaudi precīzu VRAM apjomu un paša klēpjdatora jaudas konfigurāciju, nevis paļaujies tikai uz GPU saimes nosaukumu.
Pērc Mac tieši MI darbam? Ērtākais vienotās atmiņas līmenis
Ja pērc datoru tieši tāpēc, lai regulāri lokāli darbinātu MI, ērtāks Apple variants ir 24 līdz 32 GB vienotās atmiņas: tā dod reālu rezervi lielākam modelim, garākam kontekstam vai vienkārši iespējai turēt atvērtas citas lietotnes, kamēr strādā. Izvēlies 32 GB, ja plāno to izmantot bieži un budžets to atļauj.
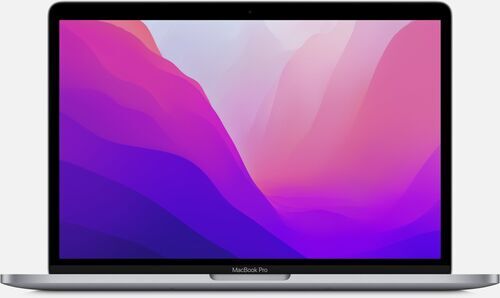
MacBook Pro 13 collu ar M2 čipu ir labs atjaunots piemērs, kas jau atrodas virs 16 GB sākuma līmeņa: tam ir 8 kodolu CPU, 10 kodolu GPU un līdz pat 24 GB vienotās atmiņas. Tā ir vecāka čipu paaudze nekā M5 Air, tāpēc šeit jārēķinās tieši ar 24 GB griestiem, nevis ar M5 Air atsevišķajām 24/32 GB konfigurācijas iespējām.
Pērc Windows vai Linux datoru? Meklē atsevišķu GPU
Ja plāno pirkt jaunu Windows vai Linux klēpjdatoru tieši lokālajam MI, meklē 32 GB sistēmas RAM kopā ar atsevišķu NVIDIA klēpjdatora GPU, kam ir vismaz 8 GB paša VRAM, vai 12 GB, ja tev der nedaudz smagāks vai dārgāks dators. 8 GB ir ticams mērķis 4–7B modeļiem Q4 precizitātē ar mērenu kontekstu, taču neuztver to kā automātisku rezervi: pat 6,6 GB lejupielādei 9B Q4 modelim ērtai darbībai var būt vajadzīgs vairāk nekā tikai 8 GB, bet 12 GB vienkārši padara šāda izmēra modeļu testēšanu vieglāku.
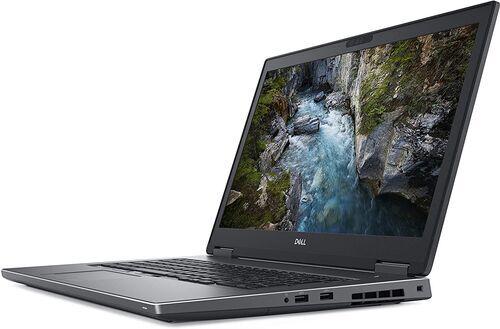
Dell Precision 7730 ir reāls atjaunots piemērs šai pieejai, pat ja tajā nav tieši iepriekš minētie jaunie čipi: 32 GB sistēmas atmiņas ir savienoti ar atsevišķu NVIDIA Quadro P3200 un tās pašas 6 GB VRAM. Tā ir cita GPU paaudze un klase nekā NVIDIA pašreizējiem RTX 5060 un 5070 Ti Laptop GPU, bet atsevišķu atmiņas kopņu princips ir tas pats.

Atbildīga alternatīva: AMD klēpjdatoru čipi ar lielu atmiņas apjomu
AMD Ryzen AI Max+ 395 procesors atbalsta līdz pat 128 GB LPDDR5x sistēmas atmiņas atkarībā no konkrētā klēpjdatora konfigurācijas. Tā ir cita atmiņas arhitektūra, kuru ir vērts ņemt vērā, taču te ir arī būtiska nianse: Ollama Linux ROCm atbalsta sarakstā šis čips ir minēts, bet Windows ROCm sarakstā šobrīd nav.
Tas ir iemesls pārbaudīt konkrētā klēpjdatora uzstādīto atmiņu, operētājsistēmu, GPU aizmugursistēmu, draiveri un Ollama darbību, pirms to iesaki, nevis iemesls šo čipu uzreiz noraidīt. Uztver AMD klēpjdatoru ar lielu atmiņu kā interesantu alternatīvu arhitektūru, ko vērts rūpīgi izpētīt, nevis kā noklusējuma pirmo pirkumu cilvēkam, kurš tikai sāk lokāli darbināt MI.
Programmatūras slānis: Ollama un LM Studio vienkāršos vārdos
Ollama ir vienkāršākais veids, kā panākt, lai modelis runātu tavā datorā: lejupielādē modeli, palaid to, un tev ir lokāls serveris, kas atbild uz pieprasījumiem, bez mākoņkonta lejupielādētam modelim. Tieši šis rīks stāv aiz visiem šeit redzamajiem piemēriem.
LM Studio piedāvā grafisku alternatīvu ar savu modeļu pārlūku un čata logu. Tas publicē arī savas minimālās prasības: vismaz 16 GB RAM uz Mac vai Windows, AVX2 atbalsts Windows x64 vidē un ieteicami 4 GB atsevišķas VRAM uz Windows. Katra no šiem rīkiem pareiza uzstādīšana ir atsevišķa tēma.
Vēl viens brīdinājums, pirms uzticies vienam ātruma skaitlim, ko redzi internetā: oficiālais llama-bench rīks atsevišķi mēra uzvedņu apstrādes ātrumu un ģenerēšanas ātrumu, kā arī uzrāda svārstības starp atkārtotiem testiem, nevis vienu vienīgu ciparu. Foruma ieraksts ar vienu tokenu sekundē skaitli reti paskaidro, kuru no abiem tas mērīja vai cik reižu tests tika veikts.
Kontrolsaraksts MI gatava klēpjdatora pirkšanai vai uzlabošanai
Pirms pērc vai uzlabo klēpjdatoru tieši lokālajam MI, pārbaudi konkrētās detaļas, nevis mārketinga frāzes.
Precīzs GPU modelis un VRAM apjoms. Ne tikai GPU saimes nosaukums, bet konkrētais klēpjdatora variants un tā atmiņas apjoms, jo zem viena nosaukuma var slēpties atšķirīgs VRAM daudzums.
Lodēta vai paplašināma RAM. Dažos klēpjdatoros atmiņu vēlāk var pievienot, daudzos modernos plānos modeļos to nevar. Noskaidro, kuru variantu pērc.
Brīva SSD vieta. Modeļu lejupielādes var būt mazākas par 1 GB vai krietni lielākas par 10 GB, un augoša kolekcija ātri aizņem vietu līdzās citiem failiem.
Termiskā uzvedība ilgstošas slodzes laikā. Modelis, kas atbild uz vienu jautājumu, un klēpjdators, kas pēc kārtas apstrādā vairākus pieprasījumus, ir divi dažādi testi; ventilatoru troksnis un veiktspējas samazināšanās pēc atkārtotām uzvednēm pasaka vairāk nekā viena ātra demonstrācija.
OS un draiveru atbalsts. Pārliecinies, ka tavam konkrētajam GPU aizmugursistēmas un operētājsistēmas salikumam ir Ollama vai LM Studio atbalsts, pirms to pieņem par pašsaprotamu.
NPU TOPS skaitlis uz kastes negarantē caurlaidību. Tas ir mārketinga rādītājs, nevis pārbaudīts rezultāts no dzinēja, ko tu izmantosi. Miglains "AI PC" apzīmējums neaizstāj nevienu no iepriekš minētajām pārbaudēm.
Pieci atjaunoti klēpjdatori, kas jau atbilst šiem līmeņiem

Biežāk uzdotie jautājumi par MI darbināšanu klēpjdatorā
Vai man vajag atsevišķu GPU, lai MI darbinātu lokāli?
Nē. Mazs modelis darbojas uz CPU vai integrētās grafikas daudzos 16 GB klēpjdatoros, tikai ātrums svārstās vairāk nekā datorā ar atsevišķu GPU. Sāc ar 2–4B modeli, pirms pieņem, ka tev vispār vajag atsevišķu grafiku.
Vai pietiek ar 8 GB RAM?
Ne pietiekami ērti modeļiem, par kuriem ir runa šeit. 16 GB ir reālistisks sākuma punkts, ja ņem vērā, ka modelis, tā konteksta logs, dzinis un operētājsistēma izmanto vienu un to pašu atmiņu.
Vai modeļa lokāla darbināšana ir tas pats, kas tā apmācība?
Nē. Viss iepriekš minētais ir inferēšana: jautājumu uzdošana jau apmācītam modelim. Apmācība nozīmē veidot modeli no nulles, un tai vajag daudz jaudīgāku aparatūru nekā jebkuram šeit minētajam klēpjdatoram.
Vai vairāk RAM garantē ātrākas atbildes?
Nē. Lielāka atmiņa dod vairāk rezerves lielākiem modeļiem, garākam kontekstam un vairāk atvērtām lietotnēm, taču reālais ātrums ir atkarīgs no atmiņas joslas platuma, GPU aizmugursistēmas un konkrētā modeļa, nevis tikai no atmiņas apjoma.
Vai mani dati ir privāti, ja modelis darbojas lokāli?
Jā, tādā nozīmē, ka tavas uzvednes paliek tavā datorā, nevis tiek sūtītas mākoņpakalpojumu sniedzējam. Ollama pēc noklusējuma piesaistās tikai tavam klēpjdatoram un nesūta pieprasījumus nekur citur, ja vien tu apzināti neiestati piekļuvi mākonim.
Pamēģini jau šovakar, tad izvēlies droši
Tev jau ir 16 GB klēpjdators? Instalē Ollama jau šovakar un palaid vienu mazu modeli, pirms iztērē kaut centu jaunam pirkumam. Pērc tieši šim nolūkam? Uztver iepriekš redzamo kontrolsarakstu un piecus tikko apskatītos atjaunotos klēpjdatorus kā savu sākuma salīdzinājumu, nevis kārtējo mārketinga specifikāciju lapu.
Katrs klēpjdators refurbed tiek testēts un novērtēts, pirms tas nonāk piedāvājumā, tāpēc RAM un konfigurācija, ko tu pērc, ir tieši tā RAM un konfigurācija, ko saņem. Nākamais šīs sērijas ceļvedis parādīs, kā savienot pirmo lietotni ar modeli, ko tikko izmēģināji.


Pirmoreiz piesakies mūsu jaunumu vēstkopai un ietaupi 15 €!
Nekad vairs nepalaidiet garām nevienu piedāvājumu.
Informāciju par personas datu izmantošanu varat atrast mūsu Privātuma politikā.
Lejupielādējiet refurbed lietotni
iOS un Android ierīcēm


Apstiprināt reģistrēšanos
Gandrīz pabeigts: mēs jums nosūtījām apstiprinājuma e‑pastu
- © Refurbed Marketplace GmbH
- Pieejamība
- Noteikumi un nosacījumi
- Privātuma politika
- Uzdruka
- Juridiskie paziņojumi
- European Data Act
- Cookie Policy